역전파 알고리즘
딥러닝 학습은 결국 “오차를 줄이도록 모든 가중치를 알맞게 조절하는 일” 입니다.
이를 위해 각 가중치가 오차에 얼마나 영향을 미쳤는지(그래디언트)를 효율적으로 구해내는 핵심 알고리즘이 바로 역전파(Backpropagation) 입니다.
마지막 출력층은 정답과 비교해 얼마나 틀렸는지 바로 알 수 있습니다.
하지만 중간에 낀 은닉층은 정답 라벨이 없습니다. 개별 은닉 노드가 몇을 내뱉어야 정답인지 중간 기준이 없는데, 최종 오차의 책임을 어떻게 물을 수 있을까요?
해답은 단순합니다. “도미노를 거꾸로 짚어가는 것” 입니다.
은닉 노드가 변하면 → \to → → \to →
역전파는 이 인과관계를 미분의 연쇄 법칙(Chain Rule) 으로 엮어, 오차가 발생한 맨 뒤(손실)에서부터 거꾸로 계산해 각 가중치의 기여도를 찾아냅니다.
특히 뒤쪽에서 구해둔 계산 결과를 앞쪽 노드들이 함께 나눠 쓰기 때문에 , 수천만 개의 가중치도 중복 없이 빠르게 계산할 수 있습니다.
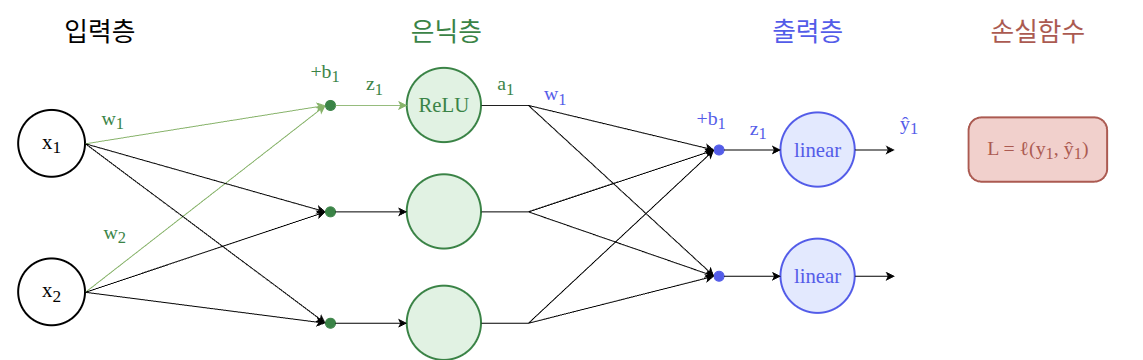
아래 단순한 신경망을 통해 이 계산이 어떻게 흘러가는지 직접 눈으로 따라가 보겠습니다.
가중치 : w w w b b b z z z a a a
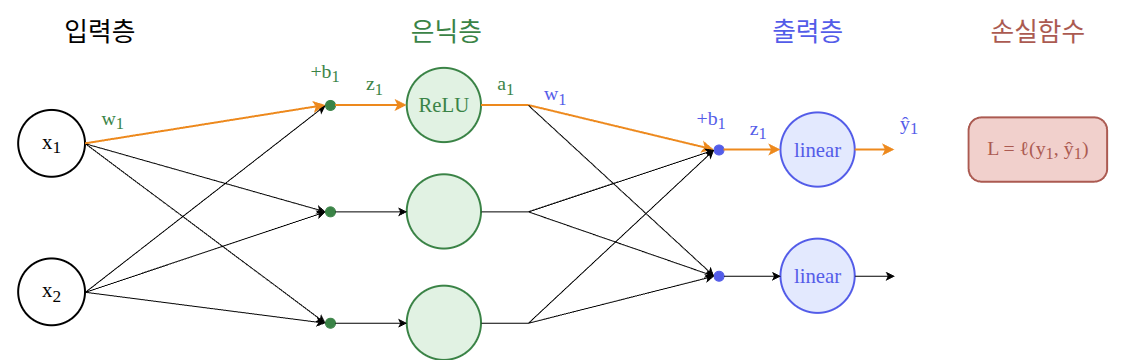
이 신경망의 계산 흐름은 다음과 같습니다. 분량상 각 층의 첫 번째 노드를 중심으로 설명합니다.
입력층: 입력 x₁ 에 가중치 w₁ 을 곱하고, 다른 입력의 가중합과 편향 b₁ 을 더합니다.
은닉층: 선형 변환 결과 z₁ 에 ReLU를 적용하여 a₁ 을 얻습니다.
출력층: a₁ 에 출력층 가중치 w₁ 을 곱하고, 다른 은닉 노드의 가중합과 편향 b₁ 을 더합니다. 선형 활성화함수는 계산한 값을 그대로 예측값 ŷ₁ 로 내보냅니다.
이과정을 순전파라고 합니다.
여기서 각 가중치들 w1, w1들의 loss에 얼마나 기여를 했는지 파악하는겁니다.
손실함수는 MSE ( L = 1 2 ( y ^ 1 − y 1 ) 2 L=\frac12(\textcolor{#2563EB}{\hat y_1}-y_1)^2 L = 2 1 ( y ^ 1 − y 1 ) 2
설명을 단순하게 하려고 손실은 첫 번째 출력 y ^ 1 \textcolor{#2563EB}{\hat y_1} y ^ 1
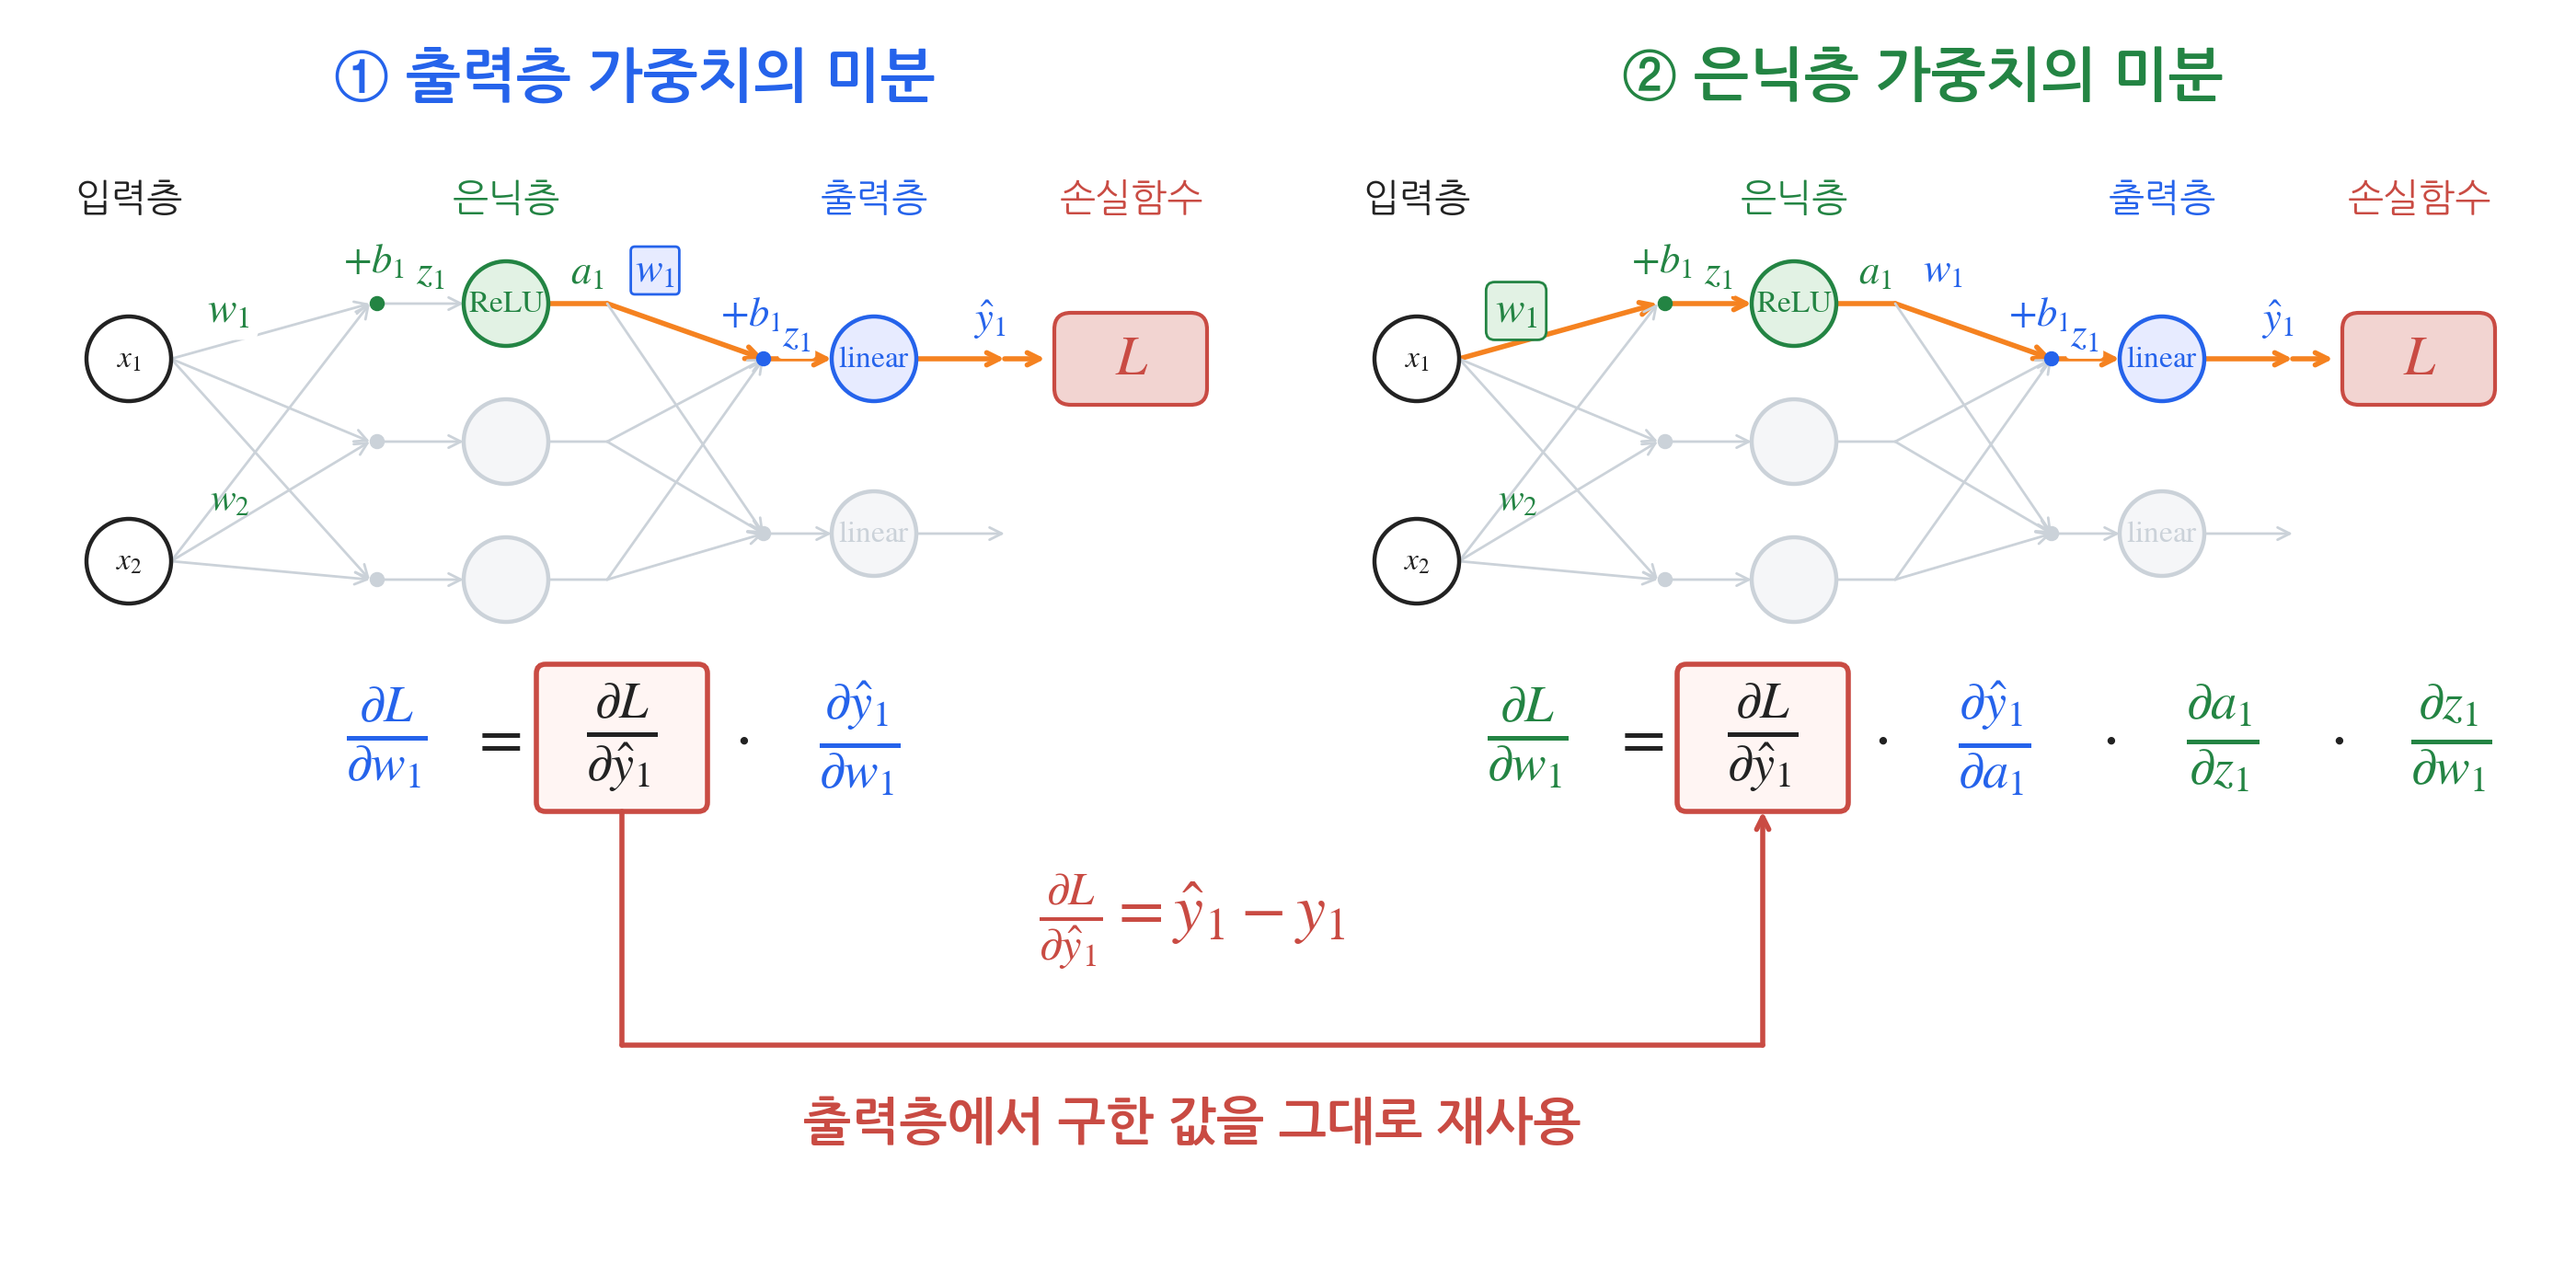
출력층 가중치의 미분
w 1 \textcolor{#2563EB}{w_1} w 1
∂ L ∂ w 1 = ∂ L ∂ y ^ 1 ⏟ ( 1 ) ⋅ ∂ y ^ 1 ∂ w 1 ⏟ ( 2 ) \frac{\partial L}{\partial \textcolor{#2563EB}{w_1}}
= \underbrace{\frac{\partial L}{\partial \textcolor{#2563EB}{\hat y_1}}}_{(1)}
\cdot \underbrace{\frac{\partial \textcolor{#2563EB}{\hat y_1}}{\partial \textcolor{#2563EB}{w_1}}}_{(2)} ∂ w 1 ∂ L = ( 1 ) ∂ y ^ 1 ∂ L ⋅ ( 2 ) ∂ w 1 ∂ y ^ 1 (1) 손실을 예측값으로 미분
지수 2가 앞으로 내려와 1 2 \frac12 2 1
L = 1 2 ( y ^ 1 − y 1 ) 2 ⇒ ∂ L ∂ y ^ 1 = y ^ 1 − y 1 L=\frac12(\textcolor{#2563EB}{\hat y_1}-y_1)^2
\quad\Rightarrow\quad
\frac{\partial L}{\partial \textcolor{#2563EB}{\hat y_1}} = \textcolor{#2563EB}{\hat y_1} - y_1 L = 2 1 ( y ^ 1 − y 1 ) 2 ⇒ ∂ y ^ 1 ∂ L = y ^ 1 − y 1 (2) 예측값을 가중치로 미분
w 1 \textcolor{#2563EB}{w_1} w 1 a 1 \textcolor{#238443}{a_1} a 1 w 1 \textcolor{#2563EB}{w_1} w 1
y ^ 1 = w 1 a 1 + ( 다른 은닉 노드 항 ) + b 1 ⇒ ∂ y ^ 1 ∂ w 1 = a 1 \textcolor{#2563EB}{\hat y_1} = \textcolor{#2563EB}{w_1}\textcolor{#238443}{a_1} + (\text{다른 은닉 노드 항}) + \textcolor{#2563EB}{b_1}
\quad\Rightarrow\quad
\frac{\partial \textcolor{#2563EB}{\hat y_1}}{\partial \textcolor{#2563EB}{w_1}} = \textcolor{#238443}{a_1} y ^ 1 = w 1 a 1 + ( 다른 은닉 노드 항 ) + b 1 ⇒ ∂ w 1 ∂ y ^ 1 = a 1 (3) 결과
∂ L ∂ w 1 = ( y ^ 1 − y 1 ) ⏟ ( 1 ) a 1 ⏟ ( 2 ) \frac{\partial L}{\partial \textcolor{#2563EB}{w_1}}
= \underbrace{(\textcolor{#2563EB}{\hat y_1} - y_1)}_{(1)}
\, \underbrace{\textcolor{#238443}{a_1}}_{(2)} ∂ w 1 ∂ L = ( 1 ) ( y ^ 1 − y 1 ) ( 2 ) a 1 은닉층 가중치의 미분
w 1 \textcolor{#238443}{w_1} w 1
∂ L ∂ w 1 = ∂ L ∂ y ^ 1 ⏟ ( 1 ) ⋅ ∂ y ^ 1 ∂ a 1 ⏟ ( 2 ) ⋅ ∂ a 1 ∂ z 1 ⏟ ( 3 ) ⋅ ∂ z 1 ∂ w 1 ⏟ ( 4 ) \frac{\partial L}{\partial \textcolor{#238443}{w_1}}
= \underbrace{\frac{\partial L}{\partial \textcolor{#2563EB}{\hat y_1}}}_{(1)}
\cdot \underbrace{\frac{\partial \textcolor{#2563EB}{\hat y_1}}{\partial \textcolor{#238443}{a_1}}}_{(2)}
\cdot \underbrace{\frac{\partial \textcolor{#238443}{a_1}}{\partial \textcolor{#238443}{z_1}}}_{(3)}
\cdot \underbrace{\frac{\partial \textcolor{#238443}{z_1}}{\partial \textcolor{#238443}{w_1}}}_{(4)} ∂ w 1 ∂ L = ( 1 ) ∂ y ^ 1 ∂ L ⋅ ( 2 ) ∂ a 1 ∂ y ^ 1 ⋅ ( 3 ) ∂ z 1 ∂ a 1 ⋅ ( 4 ) ∂ w 1 ∂ z 1 (1) 손실을 예측값으로 미분
출력층에서 구한 값과 같습니다: y ^ 1 − y 1 \textcolor{#2563EB}{\hat y_1} - y_1 y ^ 1 − y 1
(2) 예측값을 은닉 노드 출력으로 미분
같은 출력 노드 식을 이번에는 a 1 \textcolor{#238443}{a_1} a 1 a 1 \textcolor{#238443}{a_1} a 1 w 1 \textcolor{#2563EB}{w_1} w 1
y ^ 1 = w 1 a 1 + ( 다른 은닉 노드 항 ) + b 1 ⇒ ∂ y ^ 1 ∂ a 1 = w 1 \textcolor{#2563EB}{\hat y_1} = \textcolor{#2563EB}{w_1}\textcolor{#238443}{a_1} + (\text{다른 은닉 노드 항}) + \textcolor{#2563EB}{b_1}
\quad\Rightarrow\quad
\frac{\partial \textcolor{#2563EB}{\hat y_1}}{\partial \textcolor{#238443}{a_1}} = \textcolor{#2563EB}{w_1} y ^ 1 = w 1 a 1 + ( 다른 은닉 노드 항 ) + b 1 ⇒ ∂ a 1 ∂ y ^ 1 = w 1 (3) ReLU 미분
z 1 > 0 \textcolor{#238443}{z_1}>0 z 1 > 0 a 1 = z 1 \textcolor{#238443}{a_1}=\textcolor{#238443}{z_1} a 1 = z 1 a 1 = 0 \textcolor{#238443}{a_1}=0 a 1 = 0 z 1 = 0 \textcolor{#238443}{z_1}=0 z 1 = 0
a 1 = max ( 0 , z 1 ) ⇒ ∂ a 1 ∂ z 1 = ReLU ′ ( z 1 ) = { 1 ( z 1 > 0 ) 0 ( z 1 ≤ 0 ) \textcolor{#238443}{a_1} = \max(0, \textcolor{#238443}{z_1})
\quad\Rightarrow\quad
\frac{\partial \textcolor{#238443}{a_1}}{\partial \textcolor{#238443}{z_1}} = \operatorname{ReLU}'(\textcolor{#238443}{z_1}) =
\begin{cases}
1 & (\textcolor{#238443}{z_1} > 0) \\
0 & (\textcolor{#238443}{z_1} \le 0)
\end{cases} a 1 = max ( 0 , z 1 ) ⇒ ∂ z 1 ∂ a 1 = ReLU ′ ( z 1 ) = { 1 0 ( z 1 > 0 ) ( z 1 ≤ 0 ) (4) 은닉 노드 입력을 가중치로 미분
w 1 \textcolor{#238443}{w_1} w 1 x 1 x_1 x 1
z 1 = w 1 x 1 + w 2 x 2 + b 1 ⇒ ∂ z 1 ∂ w 1 = x 1 \textcolor{#238443}{z_1} = \textcolor{#238443}{w_1}x_1 + \textcolor{#238443}{w_2}x_2 + \textcolor{#238443}{b_1}
\quad\Rightarrow\quad
\frac{\partial \textcolor{#238443}{z_1}}{\partial \textcolor{#238443}{w_1}} = x_1 z 1 = w 1 x 1 + w 2 x 2 + b 1 ⇒ ∂ w 1 ∂ z 1 = x 1 (5) 결과
∂ L ∂ w 1 = ( y ^ 1 − y 1 ) ⏟ ( 1 ) w 1 ⏟ ( 2 ) ReLU ′ ( z 1 ) ⏟ ( 3 ) x 1 ⏟ ( 4 ) \frac{\partial L}{\partial \textcolor{#238443}{w_1}}
= \underbrace{(\textcolor{#2563EB}{\hat y_1} - y_1)}_{(1)}
\, \underbrace{\textcolor{#2563EB}{w_1}}_{(2)}
\, \underbrace{\operatorname{ReLU}'(\textcolor{#238443}{z_1})}_{(3)}
\, \underbrace{x_1}_{(4)} ∂ w 1 ∂ L = ( 1 ) ( y ^ 1 − y 1 ) ( 2 ) w 1 ( 3 ) ReLU ′ ( z 1 ) ( 4 ) x 1 계산한 값 재사용하기
초록색 w 1 \textcolor{#238443}{w_1} w 1 w 1 \textcolor{#2563EB}{w_1} w 1 y ^ 1 − y 1 \textcolor{#2563EB}{\hat y_1}-y_1 y ^ 1 − y 1
∂ L ∂ w 1 = ( y ^ 1 − y 1 ) ⏟ 출력층에서 이미 구한 값 w 1 ReLU ′ ( z 1 ) x 1 \frac{\partial L}{\partial \textcolor{#238443}{w_1}}
=
\underbrace{(\textcolor{#2563EB}{\hat y_1}-y_1)}_{\text{출력층에서 이미 구한 값}}
\textcolor{#2563EB}{w_1}
\operatorname{ReLU}'(\textcolor{#238443}{z_1})x_1 ∂ w 1 ∂ L = 출력층에서 이미 구한 값 ( y ^ 1 − y 1 ) w 1 ReLU ′ ( z 1 ) x 1 따라서 손실함수부터 다시 미분할 필요 없이, 파란색 w1 계산시 저장한 y ^ 1 − y 1 \textcolor{#2563EB}{\hat y_1}-y_1 y ^ 1 − y 1
미분식에 들어가는 값 중 일부는 순전파에서 이미 계산했습니다.
y ^ 1 \textcolor{#2563EB}{\hat y_1} y ^ 1 a 1 \textcolor{#238443}{a_1} a 1 w 1 \textcolor{#2563EB}{w_1} w 1 ( y ^ 1 − y 1 ) a 1 (\textcolor{#2563EB}{\hat y_1}-y_1)\textcolor{#238443}{a_1} ( y ^ 1 − y 1 ) a 1 ReLU ′ ( z 1 ) \operatorname{ReLU}'(\textcolor{#238443}{z_1}) ReLU ′ ( z 1 ) z 1 \textcolor{#238443}{z_1} z 1
그래서 순전파를 할 때 z 1 \textcolor{#238443}{z_1} z 1 a 1 \textcolor{#238443}{a_1} a 1 y ^ 1 \textcolor{#2563EB}{\hat y_1} y ^ 1
참고 자료